
ผลิตภัณฑ์หลัก
Swarm Manager
ศูนย์ควบคุมเดียวสำหรับบริหาร GPU หลายผู้เช่า ตั้งแต่สร้าง Container ไปจนถึงการตรวจสอบย้อนหลัง
เป้าหมายของแพลตฟอร์ม
- <60s
- สร้าง Container พร้อม SSH
- <30s
- คืน GPU สู่พูลกลาง (Hibernate)
ความสามารถหลัก
Swarm Manager — บริหาร GPU ทั้งคลัสเตอร์จากศูนย์ควบคุมเดียว
Swarm Manager แบ่งการ์ด GPU หลายผู้เช่าบนเครื่องเดียว จัดสรรโควตาตามจริง พักงานที่ไม่ใช้งานเพื่อคืนทรัพยากร และกู้คืนรูปแบบ MIG หลังรีบูตโดยอัตโนมัติ
ติดต่อทีมงาน →MIG Partitioning
แบ่ง GPU ตามโปรไฟล์ MIG ที่ฮาร์ดแวร์รองรับ เพื่อให้หลายงานใช้การ์ดเดียวกันได้
Smart Hibernate
พัก Container ที่ไม่ใช้งาน คืน GPU สู่พูลกลาง และเก็บข้อมูลถาวรไว้
Reboot Recovery
ระบบออกแบบให้กู้คืน layout หลังรีบูตภายใน 120 วินาที
Same-Node Guarantee
งานที่ใช้หลาย GPU ถูกจัดให้อยู่บนเครื่องแม่ข่ายเดียวกันเสมอ
One GPU per Container
จอง GPU แบบเฉพาะเจาะจงหนึ่งการ์ดต่อหนึ่ง Container
ปัญหาที่ทีมโครงสร้างพื้นฐานเจอทุกวัน — และวิธีที่เราจัดการ
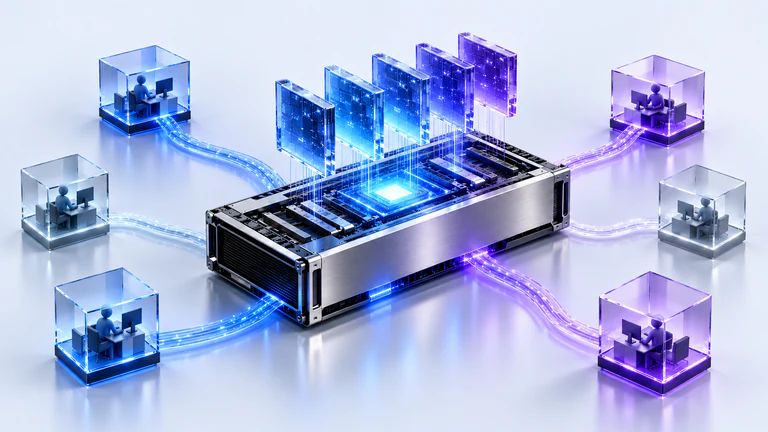
การใช้งาน GPU แบบเดิม
- จอง GPU ทั้งใบให้งานเดียว ทำให้หน่วยความจำเหลือทิ้งและการใช้งานจริงต่ำ
- ไม่มีระบบโควตากลาง ทีมต่าง ๆ แย่งทรัพยากรกัน
- ภาระค่าลิขสิทธิ์ซอฟต์แวร์บริหาร GPU จากต่างประเทศเป็นค่าใช้จ่ายรายปีต่อการ์ด
แนวทางของ GPU Plexus
- แบ่งส่วนการ์ดด้วย MIG และพักงานที่ไม่ใช้งานด้วย Smart Hibernate เพื่อคืน GPU สู่พูลกลาง
- ควบคุมโควตา 5 มิติ (vCPU, RAM, ZFS Storage, จำนวน GPU, VRAM) และแยกสิทธิ์ 3 ระดับ
- พัฒนาโดยทีมวิศวกรไทยบนมาตรฐาน NVIDIA Driver ลดการพึ่งพาซอฟต์แวร์ลิขสิทธิ์ต่างประเทศ
เป้าหมายอัตราการใช้งาน GPU
75–80%
เป้าหมาย Capacity เพิ่มขึ้น
30–50%
เป้าหมาย: จากศูนย์ถึงสภาพแวดล้อมพร้อมพัฒนา AI ภายในไม่ถึง 1 นาที
ไม่ต้องรันสคริปต์ Manual — ระบบทำงานตามลำดับอัตโนมัติ
- ขั้น 1
เลือก Image และฝัง SSH Key
ประกอบ OS Image กับ Public Key ของผู้ใช้ทันทีที่สั่งสร้าง
- ขั้น 2
ตรวจโควตา 5 มิติ
ตรวจ vCPU, RAM, ZFS Storage, GPU และ VRAM ก่อนจัดสรร
- ขั้น 3
เลือกโหนดอัจฉริยะ 2 ระดับ
งานทั่วไปกระจายไปโหนด CPU งานหลาย GPU ถูกล็อกโหนดเดียวกัน
- ขั้น 4
สร้าง ZFS Dataset และผูก MIG
สร้าง Volume พร้อมโควตาจริงและเชื่อมโปรไฟล์ MIG
- ขั้น 5
เปิด Ingress และ SSL อัตโนมัติ
จัดสรรพอร์ตจากช่วงที่กำหนดและผูกโดเมนพร้อมใบรับรอง
- ขั้น 6
พร้อมใช้งาน
Container ทำงานและเชื่อมต่อผ่าน SSH ได้
Telemetry ทุก 15 วินาที
ระบบเก็บสถิติการใช้ทรัพยากรทุก 15 วินาที
สิทธิ์ 3 ระดับ
- Admin — สร้าง/ปิดบัญชี ตั้งโควตา และดู Container ทั้งหมด
- Reseller — แบ่งโควตาของตนเองให้ลูกค้า เห็นเฉพาะงานที่ดูแล
- User — ใช้งาน Container ตามโควตาที่ได้รับ
โควตา 5 มิติ
- vCPU
- RAM
- ZFS Storage
- จำนวน GPU
- VRAM
Audit Trail
บันทึกเหตุการณ์สำคัญย้อนหลัง 365 วัน
ตัวอย่างชื่อ event
- container.created
- user.resource_allocated
- user.role_changed
หกโมดูลหลักของแพลตฟอร์ม
ทุกโมดูลทำงานบนข้อมูลชุดเดียวกัน ทำให้สิ่งที่เห็นในพอร์ทัลตรงกับสถานะจริงของคลัสเตอร์
Container
สร้าง เริ่ม หยุด พัก และปลุกงาน พร้อม health check, environment, cron และ log แบบสด
Image
ประกอบ OS image พร้อม SSH key ของผู้ใช้ รองรับ private registry และไฟล์ .tar สำหรับ import
Volume & Storage
Shared Volume Tree บน ZFS พร้อมโควตา snapshot รายวัน และการสำรอง/กู้คืน
Port & Ingress
จัดสรรพอร์ตจากช่วงที่กำหนดและผูกโดเมนพร้อมใบรับรองอัตโนมัติ
GPU & MIG
จอง GPU หนึ่งการ์ดต่องาน วาง layout ตามโปรไฟล์ที่รองรับ และรายงานความคลาดเคลื่อนหลังรีบูต
Fleet & Monitoring
ลงทะเบียนโหนด ตรวจ heartbeat วางงานตามทรัพยากรที่เหลือ และเก็บ metric ทุก 15 วินาที
ความโปร่งใสทางวิศวกรรม
สิ่งที่เราออกแบบไว้เพื่อให้ระบบคาดเดาได้และแก้ปัญหาได้จริง
แยกเจตนาออกจากสถานะจริง
ฐานข้อมูลเก็บสิ่งที่ระบบตั้งใจให้เป็น ส่วนสถานะจริงถูกอ่านจากคลัสเตอร์และแคชไว้ชั่วคราวเพื่อลดภาระการอ่าน
แก้สเปกด้วยการสร้างใหม่
การเปลี่ยนสเปกทำงานเป็นการสร้าง Container ใหม่พร้อมย้อนกลับได้ หากขั้นตอนใดล้มเหลว
ปลุกงานให้ตรงทรัพยากร
การปลุก Container จับคู่กับ GPU ชุดที่มี VRAM เพียงพอ ไม่ใช่แค่เครื่องว่าง
รายงานความคลาดเคลื่อน
เมื่อ layout ของ GPU ไม่ตรงกับที่บันทึกไว้ ระบบรายงานให้ผู้ดูแลตัดสินใจ ไม่แก้เงียบ ๆ
สามรูปแบบการส่งมอบ
เลือกรูปแบบให้เหมาะกับวิธีที่องค์กรดูแลโครงสร้างพื้นฐานอยู่แล้ว
Software License & Subscription
ติดตั้ง Swarm Manager บนโครงสร้างพื้นฐานขององค์กร (Self-Hosted / On-Premise) โดยคิดตามจำนวนโหนดหรือ GPU เป็นรายปี
Implementation & Support
ออกแบบและติดตั้งโครงสร้างพื้นฐาน AI Server ปรับแต่งซอฟต์แวร์ตามความต้องการ พร้อมดูแลตามข้อตกลงระดับบริการรายปี
GPU-as-a-Service
เช่า Container พร้อม GPU และ VRAM ตามสเปกโควตาและระยะเวลาที่ใช้ เหมาะกับงานที่มีความต้องการเปลี่ยนแปลง
ออกแบบมาสำหรับทีมที่ต้องใช้ GPU ให้คุ้มที่สุด
- 01
แบ่ง GPU ได้ละเอียด
ใช้ MIG แบ่งการ์ดให้หลายงานโดยไม่ต้องจองทั้งใบ
- 02
คืนทรัพยากรอัตโนมัติ
Hibernate งานที่ไม่ใช้งานและเก็บข้อมูลถาวรด้วย ZFS Snapshot
- 03
ควบคุมโควตาจริง
โควตา 5 มิติและสิทธิ์ 3 ระดับ ตรวจก่อนสร้าง Container ทุกครั้ง
- 04
ติดตั้งในองค์กรได้
รูปแบบ Self-Hosted License และ Managed Service โดยไม่ผูกกับผู้ให้บริการรายเดียว
- 05
มีทีมไทยดูแล
พัฒนาและสนับสนุนโดยทีมวิศวกรในประเทศไทย
พร้อมออกแบบโครงสร้างพื้นฐาน AI ที่เหมาะกับองค์กรคุณหรือยัง
เล่าโจทย์ของคุณให้ทีมวิศวกรฟัง เราจะช่วยประเมินแนวทางและขนาดคลัสเตอร์ที่เหมาะสม